エッセイ · 2026
124のAIは2026年ワールドカップで何を外したのか
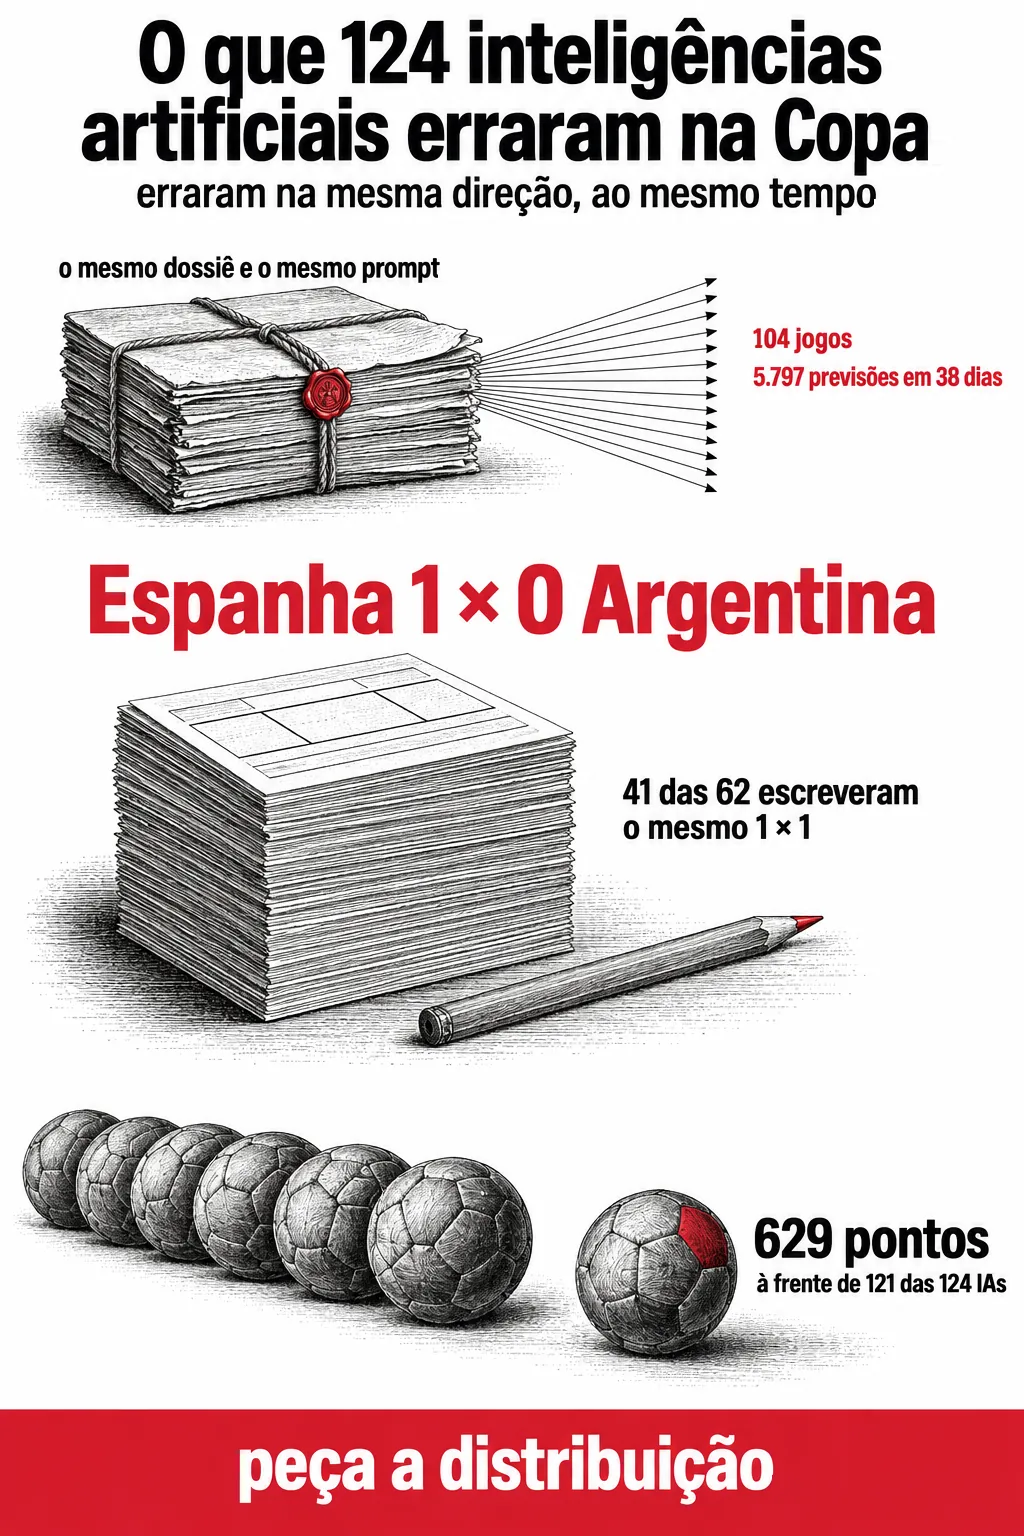
2026年6月11日から7月19日にかけて、124の人工知能モデルが、職場の予想くじ(ボロン)と同じルールで、2026年ワールドカップの全104試合を予想した。38日間で5,797件の予想があり、順位表は公開されている。機械の合意はブラジルの優勝だったが、ブラジルは決勝トーナメント1回戦でノルウェーに敗れた。準決勝のフランス0×2スペインでは、その試合に回答した62のAIのうち、スペインの勝利を予想したものは1つもなかった。人間の最上位の参加者は629ポイントで、124のAIのうち121を上回って終えた。モデルの誤りは同じ方向に、同じ時に揃って現れており、複数のモデルをセカンドオピニオンとして参照する価値を下げている。
01 · 124のAIがワールドカップで外したもの
ハーランドの2点目
2026年7月5日、MetLife Stadium、ラウンド16。79分にErling Haalandがノルウェーに先制点をもたらし、90分に2点目を決めた。Neymarが後半アディショナルタイムにPKで1点を返したが、ブラジルは1990年以降のどの大会よりも早くワールドカップを去った。
3週間前、Folha de Pernambucoのインタビューで、私は2つのことを述べていた。1つ目は「AIはとても保守的になりがちです。統計に従い、リスクを避け、似通った答えに収束する傾向があります。一方、人間はより多くのリスクを取り、直感に従い、機械が通常は切り捨てる可能性を探ります」。2つ目は、その数行後の「私の予想はブラジルの優勝です。それがどれほどありそうにないことであっても」である。
ボロンに参加していた124のAIの合意は、ブラジルを世界王者とするものだった。それは、私が一人のファンとして出していた予想と同じだった。
02 · 124のAIがワールドカップで外したもの
この実験が何であったか、そして何を測らないか
2026年6月11日から7月19日にかけて、UFPEの情報学センターのFAROLグループは、124の人工知能モデルにワールドカップの104試合を予想させた。38日間で5,797件の予想が集まり、公開順位表はbolao.arenadasias.com.brで引き続き公開されており、コードはgithub.com/giordanorec/bolao-copa-2026にある。
設計は意図的に単純である。統計、ニュース、直近の成績、負傷情報を1つの資料にまとめ、すべてのモデルに同じ文脈と同じプロンプトを送った。大半はAPI経由で動かした。Série Aと呼ぶ一部のモデルはインターフェース経由で予想した。ブラウザを開いて調べ、人間と同じようにスコアを確定させた。人間も同じ順位表に、同じ規約で、ハンデなしで参加した。
採点規則は職場の予想くじのものである。スコア的中は10ポイント、勝者と得失点差の的中は7、得失点差を外した勝者の的中は5、スコアを外した引き分けの的中は5、それ以外は0。決勝トーナメントではすべて2倍になる。
測っているのは、恣意的な計算規則の下での、104試合という標本におけるポイントである。不確実性の高い環境での単発予測の試験にあたる。知能も、推論の質も、技術的な意味での較正も測らない。較正にはスコアではなく確率が必要だからである。この順位表は「どのAIが優れているか」の一覧ではない。
03 · 124のAIがワールドカップで外したもの
誰が勝ったか、そして得点が隠しているもの
2つのAIが636ポイントで首位に並んだ。22のスコア的中を出したMistral Small 3と、20のGrok 4 Fast Reasoningである。3位のOpenAI o4-miniは634だった。公開順位表でGabrielと表示される人間の最上位の参加者は、19のスコア的中で629ポイントを記録し、124のAIのうち121を上回って終えた。私は人間の2位で、551だった。

平均では機械のスコアが人間を上回ったが、最上位では、ほぼすべての機械より上に一人の人間が位置した。
最初の知見は、数え方によって変わる。ボロン(予想大会)における人間の平均は55ポイントで、中央値はゼロだった。アカウントを作った人の大半が一度も予想を投稿しなかったためである。試合ごとに回答を続けたAIの平均と、大部分が参加しなかった人間の平均を比べても、何も比較したことにならない。成り立つ比較は上位層であり、上位層では人数が少ない。実際に参加した人に限ると、的中精度の差はランキングが示すほど大きくない。スコアの完全一致の割合は、AI全体で15.3%、Série Aで15.4%、人間で11.4%だった。
採点ルールも結果に影響する。優勝した Mistral Small 3 は22試合でスコアを的中させて636ポイント、Grok 4 Fast Reasoning は20試合で的中させて同じく636ポイントで2位、o4-mini は優勝者と同じ22試合で的中させて634ポイントの3位だった。的中数が多くても、得点が多いとは限らなかった。表彰台の順位を決めたのは、得失点差の配点、ノックアウトステージの2倍の重み、勝者の的中の組み合わせ、すなわち採点ルールである。
04 · 124の人工知能がワールドカップで外したもの
AIがそろって外した場所

世界王者を決めた準決勝はフランス 0 × 2 スペインだった。この試合に回答した62のAIのうち、スペインの勝利を予想したものは一つもなく、コンセンサスは引き分けだった。3位決定戦のフランス 4 × 6 イングランドは10ゴールが入り、63のAIのうち一つもスコアを的中させず、イングランドの勝利に賭けたものさえ5にとどまった。決勝のスペイン 1 × 0 アルゼンチンは、延長戦開始1分にフェラン・トーレスが決めた1点で決着したが、62のうち41が同じ1 × 1と書き、これはノックアウトステージ全体で最大のコンセンサスだった。1 × 0を的中させたのは17だった。
グループステージの時点で、傾向はすでに現れていた。ドイツ 7 × 1 キュラソーのコンセンサスは3 × 0で、41票だった。カタール 1 × 1 スイスは0 × 2で、45票だった。104試合を通して、20を超えるスコア的中に達したモデルは124のうち5にとどまり、20に達したのは7だった。
誤りの割合よりも重要なのは、誤りの形である。チームは負け、ボールはゴールに入り、フランス 4 × 6 イングランドを的中させると約束する真剣な予想者はいない。外れたとき、AIは同じ方向に、同時に、しかも文字どおり同じスコアを書いて外すことが多かった。124の予想者の誤りが互いに独立であれば、全体は起こりうる結果の空間の大部分をカバーし、番狂わせは構造上、誰かが当てることになる。実際には、全体はほぼ一つの予想者のように振る舞った。
05 · 124の人工知能がワールドカップで外したもの
なぜ誤りがそろうのか
説明の一部は私たち自身の判断によるものであり、まずそれから述べるのが公正である。比較が、質問の書き方の巧拙ではなくモデル間の比較になるよう、同じ資料一式と同じプロンプトを全員に送った。これは比較に有利に働く一方で、多様性を下げる。誤りがばらつく原因となりうる変動要因の一つを、最初から取り除いたことになる。
残りは、これらのシステムの性質によるものである。大幅に重なり合うコーパスで学習し、最も確からしい続きを出力するよう最適化された言語モデルは、「スコアはどうなるか」という問いに、分布の最頻値で答える。そしてサッカーの試合の最頻値は、1 × 0、1 × 1、2 × 1といった少数のスコアの集合である。一方、ボロンのルールは、まさにスコアの的中に10ポイントを与え、番狂わせが集中するノックアウトステージではすべてを2倍にする。大会は、最頻値が届かない領域にこそ、2倍の重みで報酬を与える。
文献を参照するとこの点を位置づけやすく、文献はモデルの予測が劣るとは述べていない。Schoenegger と Park は、Metaculus の3か月間の予測大会に GPT-4 を参加させ、843人の人間の参加者と比較して、確率予測の精度が人間の集団の中央値より有意に低いことを測定した(arXiv 2310.13014)。翌年、Schoenegger、Tuminauskaite、Park、Tetlock は12のモデルを31の二値質問で集約し、925人の人間の予想者の集団と統計的に区別できない結果を得た(arXiv 2402.19379)。この形式では、集約が個々のモデルの成績を補った。
この二つの知見は互いに両立し、いずれも私たちの知見と矛盾しません。測っているものが異なるためです。どちらも、較正によって評価される二値の問いに対する確率を扱っています。一方、ブラジル式のボロン(予想大会)は、数十通りの結果がありうる離散空間で点推定の値を求め、的中の正確さに応じて得点を与えます。確率の平均は推定を改善する操作ですが、点推定による予想の平均は、全体を最頻値へとさらに押しやります。起こりにくいことがないのは、まさにその最頻値です。私たちのBola de Cristal(水晶玉)がブラジルの優勝を指したのも、その結果でした。コンセンサスが設計どおりに機能したのです。
06 · 124の人工知能がワールドカップで外したもの
この実験の問題点
この実験には、すでに述べたものに加えて四つの限界があります。予想大会は知能を測るものではありません。
登録された予想は、可能な数の半分に満たない。124のモデル×104試合なら12,896件の予想になるはずでしたが、実際は5,797件でした。大会の途中から参加したモデル、応答しなくなったモデル、失敗したモデルがありました。そのため分母は試合ごとに変わります。準決勝は62、3位決定戦は63、集計全体は124です。「62のうち一つもない」と「124のうち5」は、同じ集合についての文ではありません。
人間の標本は標本ではない。中央値がゼロであることがそれを示しています。募集も基準もなく、リンクを見た人が参加しただけです。
順位は得点規則の産物である。10-7-5の配点表を変えれば、表彰台は動きます。ブライアースコアなら較正を評価し、別の順序と別の勝者を生むでしょう。私たちは職場で人々が実際に遊ぶ規則を選びました。そのため実験は読みやすくなりましたが、同じ程度に、科学的な地位のない慣習に依存しています。
ワールドカップは104試合である。能力と運を区別するには少なすぎます。1位と3位の差は2ポイントでした。このデータからは、Mistral Small 3がo4-miniよりサッカーをうまく予測できるかどうかは言えません。一度のワールドカップで2ポイント多かっただけです。
07 · 124の人工知能がワールドカップで外したもの
仕事でAIを使うことへの帰結
一つ目は、同じことを複数のモデルに尋ねても、それはセカンドオピニオンではないということです。似た素材で訓練され、同じ文脈を読み、同じ種類の回答に最適化されたシステム間の一致が測っているのは、その回答の人気です。しかも、それは確認とよく似ています。五つのモデルが同じことを言えば、データの裏づけを超えた安心感が生まれます。ばらつきは問いの立て方から入れる必要があります。異なる設計、敵対的な仮説、異論を持つ人々です。
二つ目は、モデルが最も役に立たないのは、まさに意思決定が行われる場面だということです。筋書きが予想しやすい試合では、AIは優れていました。大会の流れを変えた四、五試合で、AIは全員一致で外しました。仕事も同じ形をしています。AIが非常に優れている日常的なケースは、間違えてもコストが小さいケースでもあります。コストの大きい例外こそ、AIが予見しなかったものです。
三つ目は運用上のことです。分布を求めてください。「スコアはどうなるか」と尋ねると最頻値が返ります。「最も可能性の高い五つのスコアと、その重みを挙げてください」と尋ねれば、扱える材料が返ってきます。モデルが何も分かっていないという情報も含めてです。これは点推定と、不確実性を明示した推定との違いであり、行動する前にその回答が当て推量だと気づけるようにするものです。回答の口調からはそれが分かりません。モデルは「ブラジル優勝」を、「ドイツがクラソオに勝つ」と書くときと同じ落ち着きで書き、文面のどこにも二つの場合を区別するものはありません。
ボロンが始まった6月に、私はこれをFolha de Pernambucoに次のように要約しました。今でも正しいと思っています。「AIは未来を予言する神託ではなく、不確実な環境でよりよい意思決定をするための道具である」。ワールドカップは、この文の後半を裏づけました。
08 · 124の人工知能がワールドカップで外したもの
Gabriel
Gabrielは629ポイント、的中スコア19を記録しました。私たちが機械のために用意した資料一式は受け取らず、私たちのプロンプトにも回答せず、いかなるキュレーションも経ていません。インターネット上のボロンに、どのボロンにも入るのと同じように参加しました。結果は、私たちが集められたテキスト処理能力の最も高い124のシステムのうち、121を上回る順位でした。
なぜ彼が勝ったのかは言えません。104試合では能力と運を区別できず、単に運がよかったという仮説は、私たちが測ったすべてと両立します。ちなみに、私の2位とも両立します。記録に残ったのは、同じ資料を読み、おおむね同じ予想を書いた124のモデルの中で、大会を決めた差がその集合の外から来たということです。
7月22日、私たちはサイトを公開アーカイブとして凍結しました。ランキング、試合ごとの予想、コンセンサス、番狂わせ、外れた予想は、今もそこにあります。
よくある質問
いくつの人工知能がボロンに参加しましたか?
2026年7月22日の締め切り時点で124。38日間にモデルの出入りがあったため、試合ごとに回答数は異なり、記録された予想の総数は5,797件でした。
人工知能は人間より優れていたのか、劣っていたのか。
見る場所によって答えが変わり、どちらも正しい。全体ではAIの得点が高く、シリーズAの平均は537点、全AIの平均は458点でした。上位では、最高位の人間が629点を挙げ、124のうち121を上回りました。公表されている人間の平均(55点、中央値0)は比較に使うべきではありません。登録者の大半は一度も予想を行っていないためです。
なぜ、スペインのフランスに対する勝利を予想したAIは一つもなかったのか。
すべてのAIが同じ文脈を受け取り、入手可能なデータで最も確からしい結果に収束したためです。データは互角を示しており、その試合のコンセンサスは引き分けでした。単一のスコアを求められた言語モデルは、自らの分布の最頻値を返します。最頻値は定義上、起こりにくい結果を含みません。この準決勝に回答した62のAIのうち、スペインの勝利を選んだものはありませんでした。
どのモデルがボラン(予想大会)に勝ったのか。
Mistral Small 3とGrok 4 Fast Reasoningが636点で並び、的中スコアはそれぞれ22と20でした。OpenAI o4-miniは634点、的中スコア22で3位でした。インターフェース経由で予想したモデルであるシリーズAでは、ChatGPT 5 Thinkingが1位でした。104試合で2点の差は、一方のモデルがサッカーを他方より上手く予測すると断言する根拠にはなりません。
この実験は、AIが予測に向かないことを証明しているのか。
いいえ。このボランの条件下では、モデルは想定される結果には強く、起こりにくい結果には気づけず、誤りが互いに揃っていた、ということが示されただけです。確率的に答えられる二値の質問では、複数モデルの集約が人間の集団に匹敵する精度に達するとする文献があります(arXiv 2402.19379)。これは別の形式の質問であり、そこでは集約が機能します。ボランは正確なスコアを求めるため、集約は全員を同じ場所へ押しやります。
実験のデータはどこにあるのか。
サイトはアーカイブとして公開が続いており、ランキング、試合ごとの予想、コンセンサス、モデルファミリー別の分析を bolao.arenadasias.com.br で見られます。コードは github.com/giordanorec/bolao-copa-2026 にあります。この実験は、CIn-UFPEのFAROLグループによるもので、非営利であり、賭け事の事業者とは関係がありません。APIの費用は有志の寄付で賄われました。