에세이 · 2026
124개 인공지능은 2026년 월드컵에서 무엇을 틀렸는가?
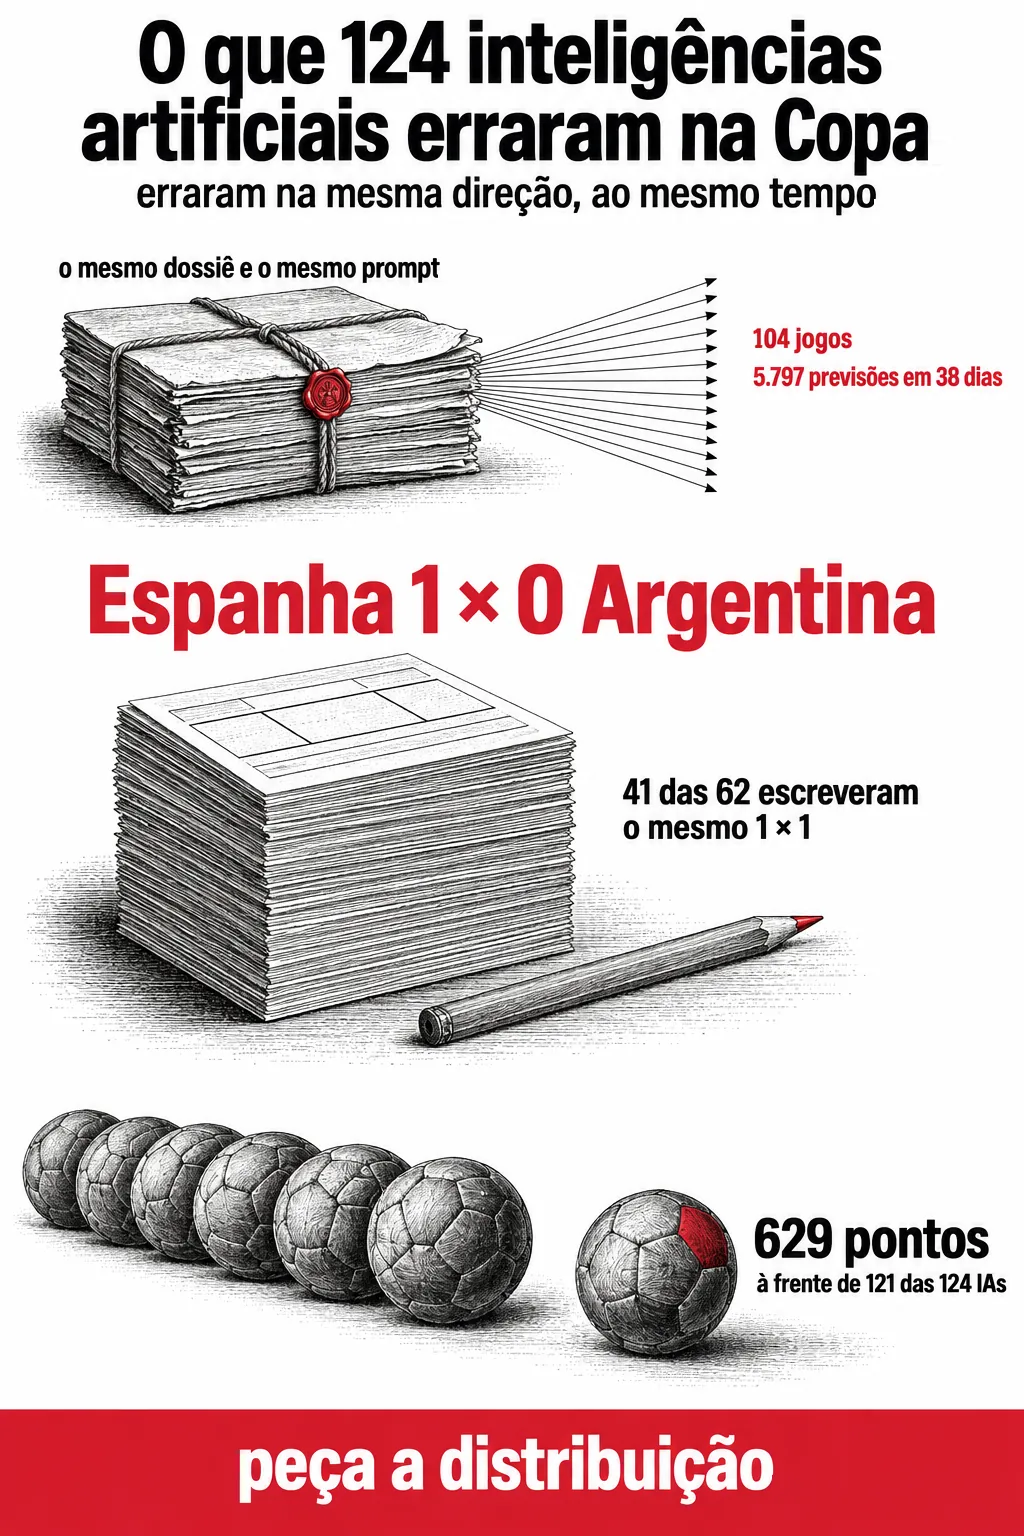
2026년 6월 11일부터 7월 19일까지, 124개 인공지능 모델이 사무실 승부 예측 모임(볼랑)과 동일한 규칙으로 월드컵 104경기를 예측했다. 38일 동안 5,797건의 예측이 이루어졌고 순위는 공개되었다. 기계들의 합의는 브라질의 우승이었으나, 브라질은 16강에서 노르웨이에게 졌다. 프랑스 0 × 2 스페인으로 끝난 준결승에서는 해당 경기에 답한 62개 AI 중 어느 것도 스페인의 승리를 예측하지 못했다. 가장 성적이 좋은 인간 참가자는 629점을 얻어 124개 AI 중 121개보다 앞섰다. 모델들의 오류는 같은 방향으로, 같은 때에 나란히 나타났으며, 이는 여러 모델에 두 번째 의견을 구하는 일의 가치를 떨어뜨린다.
01 · 124개 인공지능이 월드컵에서 틀린 것
홀란의 두 번째 골
2026년 7월 5일, 메트라이프 스타디움, 16강전. 후반 79분에 엘링 홀란이 노르웨이의 선제골을 넣었고, 90분에 두 번째 골을 넣었다. 네이마르가 추가 시간에 페널티킥으로 한 골을 만회했으나, 브라질은 1990년 이후 어느 대회보다 일찍 월드컵을 떠났다.
3주 전, Folha de Pernambuco와의 인터뷰에서 나는 두 가지를 말했다. 첫째: "AI는 매우 보수적인 경향이 있습니다. 통계를 따르고, 위험을 피하며, 비슷한 답으로 수렴하곤 합니다. 반면 인간은 더 많은 위험을 감수하고, 직관을 따르며, 기계가 대개 버리는 가능성을 탐색합니다." 둘째, 몇 줄 뒤: "제 기대는 브라질의 우승입니다. 그럴 가능성이 아무리 낮더라도요."
볼랑에 참가한 124개 인공지능의 합의는 브라질을 세계 챔피언으로 꼽았고, 이는 내가 팬으로서 내놓았던 예측과 같았다.
02 · 124개 인공지능이 월드컵에서 틀린 것
이 실험이 무엇이었고, 무엇을 측정하지 않는가
2026년 6월 11일부터 7월 19일까지, UFPE 정보학센터의 FAROL 그룹은 124개 인공지능 모델에 월드컵 104경기를 예측하게 했다. 38일 동안 5,797건의 예측이 이루어졌고, 공개 순위는 bolao.arenadasias.com.br에 계속 게시되어 있으며 코드는 github.com/giordanorec/bolao-copa-2026에 있다.
설계는 일부러 단순하게 했다. 통계, 뉴스, 최근 성적, 부상 정보를 하나의 자료집으로 모아 동일한 맥락과 동일한 프롬프트를 모든 모델에 보냈다. 대부분은 API로 실행되었다. 우리가 A 시리즈라고 부른 일부는 사람이 하듯 인터페이스로 예측했다. 브라우저를 열고, 검색한 뒤, 스코어를 확정했다. 그리고 사람들도 같은 규정에 따라, 핸디캡 없이 같은 순위에 참여했다.
점수 규칙은 사무실 승부 예측 모임의 방식이다. 정확한 스코어는 10점, 승자와 골 득실차를 맞히면 7점, 득실차 없이 승자만 맞히면 5점, 스코어 없이 무승부만 맞히면 5점, 나머지는 0점이다. 토너먼트에서는 모두 두 배가 된다.
이 실험이 측정하는 것은 임의적인 계산 규칙에 따른, 104경기라는 표본에서의 점수, 곧 불확실성이 높은 환경에서의 단일 예측 시험이다. 지능도, 추론의 질도, 확률이 필요하고 스코어로는 되지 않는 기술적 의미의 보정(calibration)도 측정하지 않는다. 순위표는 "어느 AI가 더 나은가"를 보여 주는 표가 아니다.
03 · 124개 인공지능이 월드컵에서 틀린 것
누가 이겼는가, 그리고 스코어가 가리는 것
두 AI가 636점으로 공동 선두를 차지했다. 정확한 스코어 22개의 Mistral Small 3와 20개의 Grok 4 Fast Reasoning이다. 3위 OpenAI o4-mini는 634점을 얻었다. 공개 순위에서 Gabriel이라 불리는 최고의 인간 참가자는 정확한 스코어 19개로 629점을 얻어 124개 AI 중 121개보다 앞섰다. 나는 551점으로 인간 참가자 2위였다.

평균적으로는 기계가 사람보다 높은 점수를 냈고, 최상위권에서는 한 사람이 거의 모든 기계보다 앞섰다.
첫 번째 확인 결과는 집계 방식에 따라 달라진다. 내기에서 사람들의 평균은 55점이었고 중앙값은 0이었는데, 계정을 만든 사람 대부분이 한 번도 예측을 입력하지 않았기 때문이다. 경기마다 계속 답한 AI의 평균을, 상당수가 아예 참여하지 않은 사람들의 평균과 비교하는 것은 아무것도 비교하지 않는 것과 같다. 성립하는 비교는 최상위권에서의 비교이며, 최상위권에서는 사람의 수가 적다. 실제로 참여한 사람들만 놓고 보면, 정확도 차이는 순위가 시사하는 것보다 작다. 정확한 스코어 적중률은 AI 전체 15,3%, 세리에 A 15,4%, 사람 11,4%이다.
점수 규정도 결과에 영향을 준다. 우승한 Mistral Small 3은 정확한 스코어를 22번 맞혀 636점을 얻었고, Grok 4 Fast Reasoning은 20번 맞혀 같은 636점으로 2위였다. o4-mini는 우승자와 같은 22번을 맞혀 634점으로 3위를 차지했다. 정확한 적중이 많다고 점수가 더 많은 것은 아니었다. 시상대의 순서를 가른 것은 골 득실 값, 토너먼트에서 두 배로 적용되는 가중치, 승자 적중이 결합된 결과, 즉 점수 규정이었다.
04 · 124개의 인공지능이 월드컵에서 틀린 것
함께 틀린 경기들

세계 챔피언을 가린 준결승은 프랑스 0 × 2 스페인이었다. 그 경기에 답한 62개의 AI 중 하나도 스페인의 승리를 예측하지 않았고, 다수의 예측은 무승부였다. 3위 결정전 프랑스 4 × 6 잉글랜드는 10골이 나왔는데, 63개 중 어느 것도 스코어를 맞히지 못했고 잉글랜드의 승리에 건 것도 5개뿐이었다. 연장전 첫 1분에 나온 페란 토레스의 골로 승부가 갈린 결승 스페인 1 × 0 아르헨티나에서는 62개 중 41개가 똑같이 1 × 1을 적었고, 이는 토너먼트 전체에서 가장 큰 일치였다. 17개는 1 × 0을 맞혔다.
조별리그에서 이미 이런 양상이 나타났다. 독일 7 × 1 퀴라소에 대한 다수의 예측은 3 × 0이었고, 41표였다. 카타르 1 × 1 스위스는 0 × 2였고, 45표였다. 104경기에 걸쳐 정확한 스코어를 20번 넘게 맞힌 모델은 124개 중 5개뿐이었고, 7개가 20번에 도달했다.
오류의 비율보다 중요한 것은 오류의 형태다. 팀은 지고 공은 들어가며, 어떤 진지한 예측자도 프랑스 4 × 6 잉글랜드를 맞히겠다고 약속하지는 않을 것이다. 그런데 틀릴 때 모델들은 같은 방향으로, 같은 시점에, 그리고 흔히 글자 그대로 같은 스코어를 적으며 틀렸다. 124개 예측자의 오류가 서로 독립적이었다면, 이 집합은 개연성 있는 결과의 상당 부분을 포괄했을 것이고 누군가는 이변을 구조적으로 맞혔을 것이다. 실제로는 이 집합이 사실상 하나의 예측자에 가깝게 움직였다.
05 · 124개의 인공지능이 월드컵에서 틀린 것
오류가 한쪽으로 쏠리는 이유
설명의 일부는 우리의 결정에서 비롯되며, 그것부터 말하는 것이 공정하다. 우리는 모든 모델에 같은 자료집과 같은 프롬프트를 보냈는데, 비교가 질문을 잘 쓴 사람 사이가 아니라 모델 사이에서 이루어지도록 하기 위해서였다. 이는 비교에는 유리하지만 다양성을 줄인다. 오류가 갈라지게 만들 변이의 원천 하나를 처음부터 없앤 것이다.
나머지는 이 시스템들의 본성에서 나온다. 크게 겹치는 말뭉치로 훈련되고 가장 개연성 높은 이어쓰기를 만들도록 최적화된 언어 모델은 "스코어가 어떻게 될까"라는 질문에 자기 분포의 최빈값으로 답한다. 축구 경기의 최빈값은 1 × 0, 1 × 1, 2 × 1 같은 작은 스코어 집합이다. 한편 내기 규정은 바로 정확한 적중에 10점을 주고, 이변이 몰리는 토너먼트에서는 모든 것을 두 배로 계산한다. 이 대회는 최빈값이 닿지 않는 영역을 정확히 두 배의 가중치로 보상한다.
문헌은 이를 가늠하는 데 도움이 되며, 모델이 예측을 못한다고 말하지는 않는다. Schoenegger와 Park은 GPT-4를 Metaculus의 3개월 예측 대회에 843명의 사람 참가자와 함께 출전시켰고, 확률 예측이 사람 집단의 중앙값보다 유의하게 덜 정확하다는 것을 측정했다(arXiv 2310.13014). 이듬해 Schoenegger, Tuminauskaite, Park, Tetlock은 12개 모델을 31개의 이진 질문에 걸쳐 종합했고, 925명의 사람 예측자 집단과 통계적으로 구별되지 않는 결과를 얻었다(arXiv 2402.19379). 이 형식에서는 종합이 개별 성능을 보완했다.
두 가지 결과는 서로 양립할 수 있으며, 어느 쪽도 우리의 결과와 모순되지 않습니다. 측정하는 대상이 다르기 때문입니다. 두 연구 모두 이진 질문에 대한 확률을 다루고, 보정(calibration)으로 평가합니다. 반면 승부 예측 대회(bolão)는 수십 가지의 가능한 결과가 있는 이산 공간에서 하나의 값을 요구하고, 정확도에 따라 점수를 줍니다. 확률의 평균은 추정치를 개선하는 연산이지만, 개별 예측값의 평균은 집합 전체를 최빈값 쪽으로 더 밀어 놓습니다. 그런데 일어날 법하지 않은 일은 바로 그곳에 있지 않습니다. 우리의 Bola de Cristal이 브라질을 우승팀으로 지목했을 때 일어난 일이 이것입니다. 합의가 설계된 대로 작동한 것입니다.
06 · 124개의 인공지능이 월드컵에서 틀린 것
이 실험의 문제점
이 실험에는 앞서 언급한 한계 외에 네 가지 한계가 더 있습니다. 승부 예측 대회(bolão)는 지능을 측정하지 않습니다.
가능한 예측의 절반도 기록되지 않았습니다. 124개 모델 곱하기 104경기면 12,896건의 예측이 나와야 하지만, 실제로는 5,797건이었습니다. 모델이 대회 도중에 참가하거나, 응답을 멈추거나, 실패했습니다. 그래서 분모가 경기마다 달라집니다. 준결승은 62, 3·4위전은 63, 전체 집계는 124입니다. "62개 중 하나도 없음"과 "124개 중 5개"는 같은 집합에 대한 문장이 아닙니다.
사람 표본은 표본이 아닙니다. 중앙값 0이 이를 보여 줍니다. 모집도 없었고 기준도 없었으며, 링크를 본 사람이 참여했습니다.
순위는 점수 규칙이 만들어 낸 산물입니다. 10-7-5 점수표를 바꾸면 시상대의 순서가 달라집니다. 브라이어 점수(Brier score)를 쓰면 보정 능력에 보상이 돌아가 다른 순서와 다른 우승자가 나왔을 것입니다. 우리는 사람들이 사무실에서 실제로 쓰는 규칙을 골랐습니다. 덕분에 실험은 이해하기 쉬워졌지만, 같은 정도로 과학적 지위가 없는 관례에 의존하게 되었습니다.
월드컵은 104경기입니다. 실력과 운을 가르기에는 적은 수입니다. 1위와 3위의 차이는 2점이었습니다. 이 자료만으로는 Mistral Small 3가 o4-mini보다 축구를 더 잘 예측한다고 말할 수 없습니다. 단 한 번의 월드컵에서 2점을 더 얻었을 뿐입니다.
07 · 124개의 인공지능이 월드컵에서 틀린 것
업무에서의 AI 활용에 주는 시사점
첫째, 같은 질문을 여러 모델에 하는 것은 두 번째 의견이 아닙니다. 비슷한 자료로 학습하고, 같은 맥락을 읽고, 같은 유형의 답에 맞게 최적화된 시스템들이 일치한다는 것은 그 답이 얼마나 흔한지를 측정할 뿐입니다. 그리고 그것은 확인처럼 보이기 쉽습니다. 다섯 모델이 같은 말을 하면 데이터가 뒷받침하지 못하는 안도감이 생깁니다. 분산은 질문을 통해 들어와야 합니다. 서로 다른 설계, 반대 가설, 이견을 가진 사람들이 그 통로입니다.
둘째, 모델은 결정이 내려지는 바로 그 지점에서 가장 도움이 되지 않습니다. 줄거리가 예측 가능한 경기에서는 AI가 잘 맞혔습니다. 월드컵의 흐름을 바꾼 네다섯 경기에서는 AI가 만장일치로 틀렸습니다. 업무도 같은 구조입니다. AI가 뛰어난 일상적인 사례는 틀려도 비용이 적게 드는 사례이기도 합니다. 비용이 큰 예외는 AI가 예측하지 못한 쪽입니다.
셋째는 운영상의 요령입니다. 분포를 요청하십시오. "스코어가 어떻게 될까요"라고 물으면 최빈값이 돌아옵니다. "가장 가능성이 높은 스코어 다섯 개와 각각의 비중은 무엇입니까"라고 물으면 활용할 수 있는 답이 돌아오고, 모델이 아무것도 모른다는 정보까지 포함됩니다. 이는 점추정과 불확실성을 밝힌 추정의 차이이며, 행동에 옮기기 전에 그 답이 추측임을 알아차릴 수 있게 해 줍니다. 답변의 어조로는 이를 알 수 없습니다. 모델은 "브라질 우승"을 "독일, 퀴라소에 승리"와 똑같이 차분하게 쓰며, 문장 안에는 두 경우를 구별해 주는 것이 없습니다.
6월, 승부 예측 대회가 시작되었을 때 저는 이를 Folha de Pernambuco에 이렇게 요약했고, 지금도 이 말이 옳다고 생각합니다. "AI는 미래를 예측하는 신탁이 아니라, 불확실한 환경에서 더 나은 결정을 내리기 위한 도구입니다." 이번 월드컵은 이 문장의 후반부를 뒷받침했습니다.
08 · 124개의 인공지능이 월드컵에서 틀린 것
Gabriel
Gabriel은 629점과 19개의 정확한 스코어를 기록했습니다. 그는 우리가 기계들을 위해 만든 자료집을 받지 않았고, 우리의 프롬프트에 답하지 않았으며, 어떤 선별 과정도 거치지 않았습니다. 여느 승부 예측 대회에 참여하듯 인터넷에서 대회에 들어왔습니다. 그는 우리가 모을 수 있었던, 텍스트를 처리하는 능력이 가장 뛰어난 124개 시스템 가운데 121개를 앞질러 마쳤습니다.
그가 왜 이겼는지는 말할 수 없습니다. 104경기로는 실력과 운을 가를 수 없으며, 그가 단지 운이 좋았을 뿐이라는 가설은 우리가 측정한 모든 것과 양립합니다. 덧붙이자면 제가 2위를 한 것과도 양립합니다. 확인된 사실은, 같은 자료를 읽고 상당 부분 같은 예측을 쓴 124개 모델 사이에서 대회의 승부를 가른 차이가 그 집합 바깥에서 왔다는 것입니다.
7월 22일에 우리는 사이트를 공개 아카이브로 동결했습니다. 순위, 경기별 예측, 합의, 이변, 그리고 오류가 그대로 남아 있습니다.
자주 묻는 질문
몇 개의 인공지능이 승부 예측 대회에 참가했습니까?
2026년 7월 22일 종료 시점 기준 124개입니다. 38일 동안 모델이 들어오고 나가서 경기마다 응답 수가 다르며, 기록된 예측은 모두 5,797건입니다.
인공지능은 인간보다 더 잘했을까요, 더 못했을까요?
어디를 보느냐에 따라 다르며, 두 답 모두 사실입니다. 전체로는 AI의 점수가 더 높았습니다. 시리즈 A의 평균은 537점, 전체 AI의 평균은 458점이었습니다. 최상위에서는 최고의 인간이 629점을 얻어 124개 중 121개 AI보다 앞섰습니다. 공개된 인간 평균(55점, 중앙값 0)은 비교에 사용해서는 안 됩니다. 가입자 대부분이 한 번도 예측을 하지 않았기 때문입니다.
왜 어떤 AI도 스페인의 프랑스전 승리를 예측하지 못했을까요?
모든 AI가 같은 맥락을 받았고, 모두 가용한 데이터상 가장 가능성이 높은 결과로 수렴했기 때문입니다. 데이터는 팽팽한 균형을 가리켰고, 그 경기의 합의는 무승부였습니다. 단일 스코어를 요구받은 언어 모델은 자신의 분포에서 최빈값을 내놓으며, 최빈값은 정의상 가능성이 낮은 결과를 포괄하지 않습니다. 그 준결승에 응답한 62개 AI 가운데 스페인의 승리를 택한 AI는 하나도 없었습니다.
어떤 모델이 보라(예측 대회)에서 우승했나요?
Mistral Small 3와 Grok 4 Fast Reasoning이 636점으로 동률이었고, 정확한 스코어 적중은 각각 22개와 20개였습니다. OpenAI o4-mini가 634점, 정확한 스코어 22개로 3위였습니다. 인터페이스를 통해 예측한 모델들, 즉 시리즈 A에서는 ChatGPT 5 Thinking이 1위였습니다. 104경기에서 2점 차이로는 한 모델이 다른 모델보다 축구를 더 잘 예측한다고 말할 수 없습니다.
이 실험은 AI가 예측에 쓸모없다는 것을 증명하나요?
아닙니다. 이 보라의 조건에서 모델들은 예상되는 결과에는 뛰어났고 가능성이 낮은 결과에는 눈이 멀었으며, 오류가 서로 같은 방향으로 나타났다는 것을 보여 줍니다. 확률적 답이 있는 이분형 질문에서는 여러 모델의 집계가 인간 집단과 견줄 만한 정확도에 이른다는 문헌이 있습니다(arXiv 2402.19379). 이는 다른 형식의 질문이며, 거기서는 집계가 효과가 있습니다. 보라는 정확한 스코어를 요구하고, 그 경우 집계는 모두를 같은 지점으로 몰아갑니다.
실험 데이터는 어디에 있나요?
사이트는 순위, 경기별 예측, 합의, 모델 계열별 분석을 담은 아카이브로 계속 운영되며 bolao.arenadasias.com.br에서 볼 수 있습니다. 코드는 github.com/giordanorec/bolao-copa-2026에 있습니다. 이 실험은 CIn-UFPE의 FAROL 그룹이 수행했으며 비영리이고 베팅 업체와 관계가 없습니다. API 비용은 자발적 기부로 충당했습니다.