Ensayo · 2026
¿Qué erraron 124 inteligencias artificiales en el Mundial de 2026?
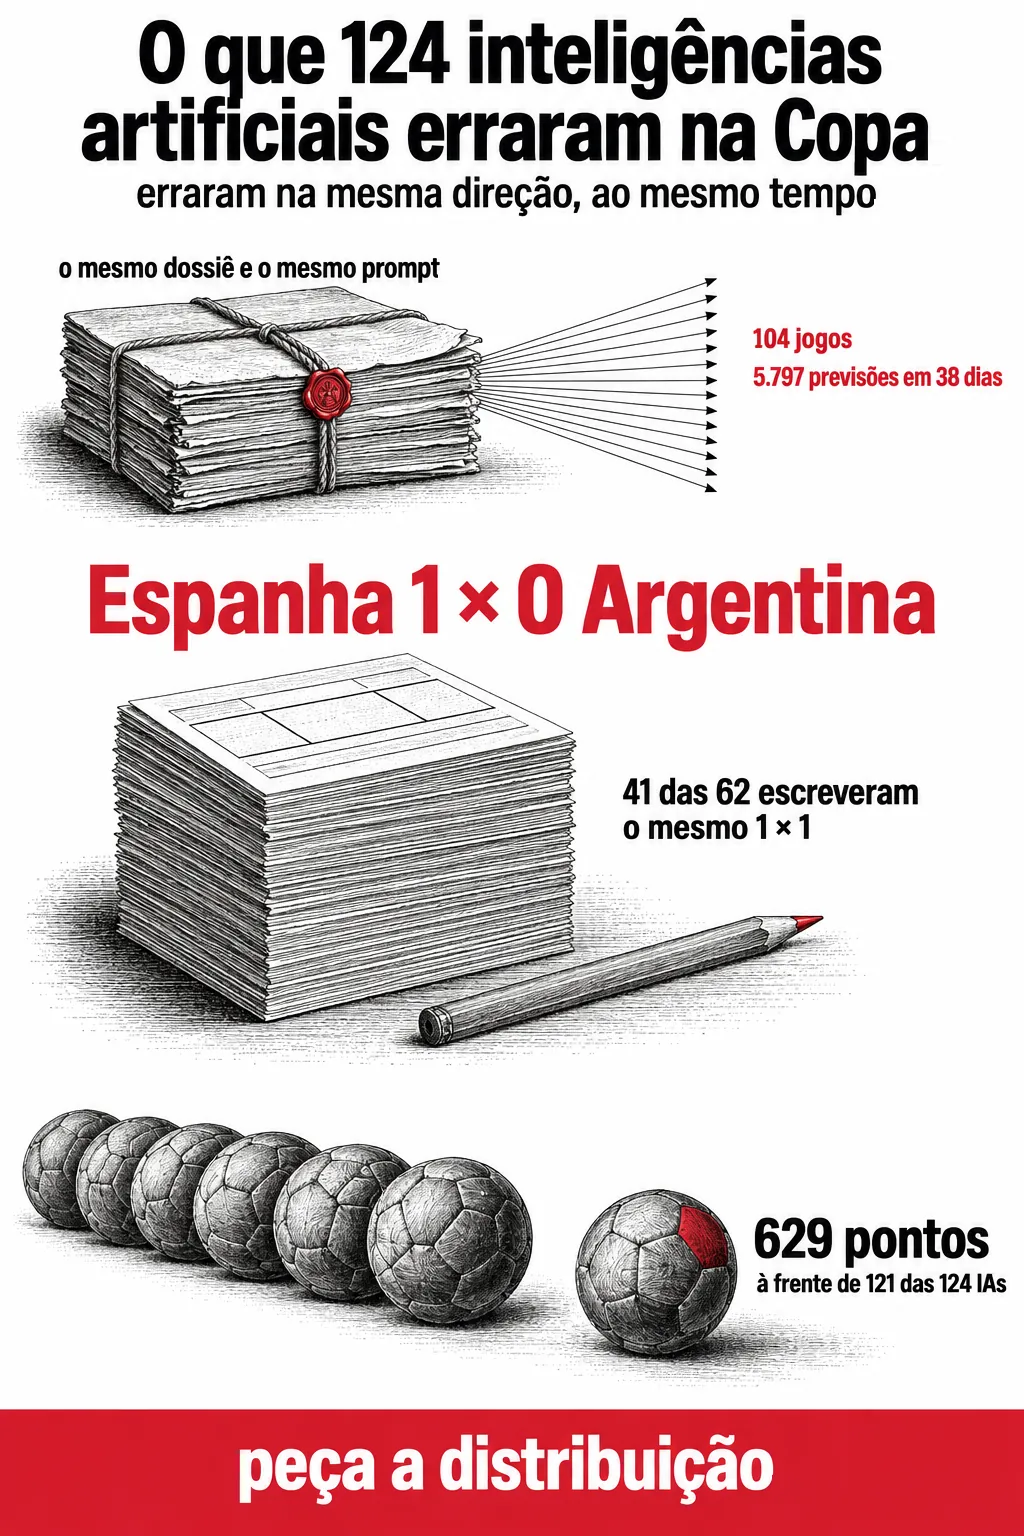
Entre el 11 de junio y el 19 de julio de 2026, 124 modelos de inteligencia artificial pronosticaron los 104 partidos del Mundial bajo las mismas reglas de una quiniela de oficina: 5.797 predicciones en 38 días, con ranking abierto. El consenso de las máquinas daba a Brasil como campeón, y Brasil cayó en octavos ante Noruega. En la semifinal Francia 0 × 2 España, ninguna de las 62 IA que respondieron sobre ese partido pronosticó la victoria española. El mejor participante humano hizo 629 puntos y terminó por delante de 121 de las 124 IA. Los errores de los modelos vinieron alineados: en la misma dirección y al mismo tiempo, lo que reduce el valor de consultar varios modelos como segunda opinión.
01 · Lo que 124 inteligencias artificiales erraron en el Mundial
El segundo gol de Haaland
Cinco de julio de 2026, MetLife Stadium, octavos de final. A los 79 minutos Erling Haaland abrió el marcador para Noruega; a los 90, hizo el segundo. Neymar descontó en el tiempo añadido, de penal, y Brasil dejó el Mundial antes que en cualquier edición desde 1990.
Tres semanas antes, en una entrevista a la Folha de Pernambuco yo había dicho dos cosas. La primera: "las IA tienden a ser muy conservadoras. Siguen las estadísticas, evitan riesgos y suelen converger hacia respuestas parecidas. Los humanos, en cambio, arriesgan más, siguen intuiciones y exploran posibilidades que las máquinas normalmente descartan." La segunda, pocas líneas después: "mi expectativa es Brasil campeón, por improbable que sea".
El consenso de las 124 inteligencias artificiales que participaban en la quiniela señalaba a Brasil como campeón del mundo, el mismo pronóstico que yo, hablando como hincha, había hecho.
02 · Lo que 124 inteligencias artificiales erraron en el Mundial
Qué era el experimento y qué no mide
Entre el 11 de junio y el 19 de julio de 2026, el grupo FAROL, del Centro de Informática de la UFPE, puso a 124 modelos de inteligencia artificial a pronosticar los 104 partidos del Mundial. Fueron 5.797 predicciones en 38 días, en un ranking abierto que sigue publicado en bolao.arenadasias.com.br y cuyo código está en github.com/giordanorec/bolao-copa-2026.
El diseño es deliberadamente simple. Reunimos estadísticas, noticias, rendimiento reciente y lesiones en un único dosier, y enviamos el mismo contexto y el mismo prompt a todos los modelos. La mayoría funcionó por API. Un subconjunto, que llamamos Série A, pronosticó por la interfaz: abrió el navegador, investigó y luego fijó el marcador, como lo haría una persona. Y personas entraron en el mismo ranking, bajo el mismo reglamento, sin handicap.
La regla de puntuación es la de la quiniela de oficina: 10 puntos por el marcador exacto, 7 por el ganador con la diferencia de goles correcta, 5 por el ganador sin la diferencia, 5 por el empate sin el marcador y cero por el resto. Todo se duplica en la fase eliminatoria.
Lo que mide son puntos, bajo una regla de conteo arbitraria, en una muestra de 104 partidos: una prueba de predicción puntual en un entorno de alta incertidumbre. No mide inteligencia, ni calidad de razonamiento, ni calibración en sentido técnico, que exigiría probabilidades y no marcadores. El ranking no es una tabla de "qué IA es mejor".
03 · Lo que 124 inteligencias artificiales erraron en el Mundial
Quién ganó y qué esconde el marcador
Dos IA terminaron empatadas en la cima, con 636 puntos: Mistral Small 3, con 22 marcadores exactos, y Grok 4 Fast Reasoning, con 20. La tercera clasificada, OpenAI o4-mini, hizo 634. El mejor participante humano, que el ranking público llama Gabriel, hizo 629 puntos con 19 marcadores exactos, y terminó por delante de 121 de las 124 IA. Yo fui el segundo humano, con 551.

En promedio, las máquinas puntuaron más que las personas; en la cima, una persona quedó por delante de casi todas las máquinas.
La primera constatación depende de cómo se cuente. La media de los humanos en la quiniela fue de 55 puntos, con mediana cero, porque la mayor parte de quienes crearon una cuenta nunca hizo un pronóstico. Comparar la media de las IA, que respondieron partido tras partido, con la media de los humanos, que en buena medida no jugaron, no compara nada. La comparación que se sostiene está en la cima, y en la cima el número de personas es pequeño. Entre quienes sí jugaron, la diferencia de precisión es más modesta de lo que sugiere el ranking: 15,3 % de marcadores exactos en el conjunto de las IA, 15,4 % en la Serie A, 11,4 % entre los humanos.
La regla de puntuación también pesa en el resultado. La campeona Mistral Small 3 acertó 22 marcadores exactos y obtuvo 636 puntos; Grok 4 Fast Reasoning acertó 20 y también obtuvo 636, en segundo lugar; o4-mini acertó 22, como la campeona, y quedó tercera con 634. Más aciertos exactos no dieron más puntos. Lo que ordenó el podio fue la combinación entre el valor de la diferencia de goles, el peso doble de la fase eliminatoria y el acierto del ganador, es decir, la regla de puntuación.
04 · Lo que 124 inteligencias artificiales erraron en el Mundial
Dónde erraron juntas

La semifinal que definió a la campeona del mundo fue Francia 0 × 2 España. De las 62 IA que respondieron sobre ese partido, ninguna predijo la victoria española; el consenso apuntaba a empate. En el partido por el tercer puesto, Francia 4 × 6 Inglaterra, diez goles, ninguna de las 63 acertó el marcador y solo cinco apostaron siquiera por la victoria inglesa. En la final, España 1 × 0 Argentina, decidida por un gol de Ferran Torres en el primer minuto de la prórroga, 41 de las 62 escribieron el mismo 1 × 1, el mayor consenso de toda la fase eliminatoria. Diecisiete acertaron el 1 × 0.
En la fase de grupos el patrón ya estaba dado. El consenso para Alemania 7 × 1 Curazao fue 3 × 0, con 41 votos. Para Catar 1 × 1 Suiza, fue 0 × 2, con 45. A lo largo de los 104 partidos, solo 5 de los 124 modelos pasaron de veinte marcadores exactos; 7 llegaron a veinte.
Más relevante que la tasa de error es la forma del error. Los equipos pierden, los balones entran, y ningún pronosticador serio prometería acertar Francia 4 × 6 Inglaterra. Cuando erraron, erraron en la misma dirección, al mismo tiempo y, con frecuencia, escribiendo literalmente el mismo marcador. Si los errores de 124 pronosticadores fueran independientes, el conjunto cubriría buena parte del espacio de resultados plausibles y alguien acertaría la sorpresa por construcción. En la práctica, el conjunto se comportó de modo próximo a un único pronosticador.
05 · Lo que 124 inteligencias artificiales erraron en el Mundial
Por qué el error llega alineado
Parte de la explicación es decisión nuestra, y es justo empezar por ella. Enviamos el mismo dosier y el mismo prompt a todos, precisamente para que la comparación fuera entre modelos y no entre quien redactó mejor la pregunta. Eso favorece la comparación y reduce la diversidad: eliminamos de entrada una de las fuentes de variación que harían divergir los errores.
El resto proviene de lo que son estos sistemas. Los modelos de lenguaje, entrenados en corpus ampliamente solapados y optimizados para producir la continuación más probable, responden a «cuál será el marcador» con la moda de su distribución. Y la moda de un partido de fútbol es un conjunto pequeño de marcadores: 1 × 0, 1 × 1, 2 × 1. La regla de la quiniela, por su parte, paga 10 puntos precisamente por la exactitud, y duplica todo en la fase eliminatoria, que es donde se concentra lo improbable. El torneo premia, con peso doble, exactamente la región a la que la moda no llega.
La literatura ayuda a situar esto, y no dice que los modelos pronostiquen mal. Schoenegger y Park inscribieron a GPT-4 en un torneo de pronósticos de tres meses en Metaculus, con 843 participantes humanos, y midieron pronósticos probabilísticos significativamente menos precisos que la mediana de la multitud humana (arXiv 2310.13014). Al año siguiente, Schoenegger, Tuminauskaite, Park y Tetlock agregaron 12 modelos en 31 preguntas binarias y obtuvieron un resultado estadísticamente indistinguible del de una multitud de 925 pronosticadores humanos (arXiv 2402.19379). En ese formato, la agregación compensó el desempeño individual.
Los dos hallazgos son compatibles entre sí, y ninguno contradice el nuestro, porque miden otra cosa. Ambos trabajan con probabilidades sobre preguntas binarias, evaluadas por calibración. Una polla pide un valor puntual en un espacio discreto con decenas de resultados posibles y paga por la exactitud. Promediar probabilidades es una operación que mejora la estimación; promediar pronósticos puntuales empuja al conjunto aún más hacia la moda, que es precisamente donde no está lo improbable. Fue lo que hizo nuestra Bola de Cristal al señalar a Brasil campeón: el consenso funcionando como fue diseñado.
06 · Lo que 124 inteligencias artificiales erraron en el Mundial
Lo que está mal en este experimento
El experimento tiene cuatro limitaciones, además de la ya mencionada: una polla no mide inteligencia.
Se registró menos de la mitad de los pronósticos posibles. Ciento veinticuatro modelos por 104 partidos darían 12.896 predicciones; fueron 5.797. Hubo modelos que entraron a mitad del torneo, dejaron de responder o fallaron. De ahí que el denominador cambie de partido a partido: 62 en la semifinal, 63 en el partido por el tercer puesto, 124 en el agregado. "Ninguna de las 62" y "5 de las 124" no son frases sobre el mismo conjunto.
La muestra humana no es una muestra. La mediana cero lo demuestra. No hubo reclutamiento, no hubo criterio, y quien participó lo hizo porque vio el enlace.
El ranking es un artefacto de la regla de puntuación. Si se cambia la tabla 10-7-5, el podio se mueve; un puntaje de Brier premiaría la calibración y produciría otro orden, con otro ganador. Elegimos la regla que la gente juega en la oficina, lo que hace el experimento legible y, en la misma medida, dependiente de una convención sin estatus científico.
Un Mundial son 104 partidos. Es poco para separar competencia de suerte. Entre la primera y la tercera clasificadas hubo dos puntos de diferencia. Estos datos no permiten decir si Mistral Small 3 predice el fútbol mejor que o4-mini; hizo dos puntos más, en un único Mundial.
07 · Lo que 124 inteligencias artificiales erraron en el Mundial
Consecuencias para el uso de IA en el trabajo
La primera es que preguntar lo mismo a varios modelos no es una segunda opinión. La concordancia entre sistemas entrenados con material parecido, que leen el mismo contexto y están optimizados para el mismo tipo de respuesta, mide la popularidad de la respuesta. Y se parece mucho a una confirmación: cinco modelos diciendo lo mismo producen una sensación de seguridad que los datos no sostienen. La varianza tiene que entrar por la pregunta: diseños diferentes, hipótesis adversarias, personas que discrepen.
La segunda es que el modelo ayuda menos justamente donde se toma la decisión. En los partidos de guion previsible las IAs fueron buenas; fue en los cuatro o cinco partidos que dieron vuelta el Mundial donde fueron unánimes y erraron. El trabajo tiene la misma forma. El caso rutinario, en que son excelentes, es también aquel en que equivocarse cuesta poco; la excepción de alto costo es la que no previeron.
La tercera es operativa: pida la distribución. "Cuál va a ser el marcador" devuelve la moda. "Cuáles son los cinco marcadores más probables y con qué peso" devuelve algo con lo que se puede trabajar, incluida la información de que el modelo no tiene idea. Es la diferencia entre una estimación puntual y una estimación con incertidumbre declarada, y es lo que permite percibir que la respuesta es una conjetura antes de actuar sobre ella. El tono de la respuesta no lo indica: un modelo escribe "Brasil campeón" con la misma serenidad con que escribe "Alemania vence a Curazao", y nada en la frase distingue los dos casos.
En junio, cuando empezó la polla, se lo resumí a la Folha de Pernambuco de una manera que todavía me parece correcta: "la IA no es un oráculo que predice el futuro, es una herramienta para tomar mejores decisiones en entornos de incertidumbre". El Mundial reforzó la segunda mitad de la frase.
08 · Lo que 124 inteligencias artificiales erraron en el Mundial
Gabriel
Gabriel hizo 629 puntos y 19 marcadores exactos. No recibió el dosier que armamos para las máquinas, no respondió a nuestro prompt y no pasó por ninguna curaduría: entró en una polla por internet, como se entra en cualquier polla. Terminó por delante de 121 de los 124 sistemas más capaces de procesar texto que logramos reunir.
No es posible decir por qué ganó. Ciento cuatro partidos no separan competencia de suerte, y la hipótesis de que simplemente tuvo suerte es compatible con todo lo que medimos, como es compatible, por cierto, con mi segundo lugar. Lo que quedó registrado es que, entre 124 modelos que leyeron el mismo material y escribieron, en buena parte, el mismo pronóstico, la diferencia que decidió el torneo vino de fuera de ese conjunto.
El 22 de julio congelamos el sitio como archivo público. Sigue ahí: el ranking, los pronósticos partido a partido, el consenso, las sorpresas y los errores.
Preguntas frecuentes
¿Cuántas inteligencias artificiales participaron en la polla?
Ciento veinticuatro, en el recuento del cierre, el 22 de julio de 2026. Los modelos entraron y salieron a lo largo de los 38 días; por eso el número de respuestas varía de un partido a otro, y el total de pronósticos registrados fue de 5.797.
¿Las inteligencias artificiales fueron mejores o peores que los humanos?
Depende de dónde se mire, y las dos respuestas son verdaderas. En conjunto, las IA puntuaron más: el promedio de la Serie A fue de 537 puntos y el de todas las IA, 458. En la cima, el mejor humano hizo 629 puntos y quedó por delante de 121 de las 124. El promedio humano publicado (55 puntos, mediana cero) no debe usarse en la comparación: la mayor parte de quienes se registraron nunca hizo un pronóstico.
¿Por qué ninguna IA predijo la victoria de España sobre Francia?
Porque todas recibieron el mismo contexto y todas convergieron hacia el resultado más probable según los datos disponibles, que apuntaba a equilibrio: el consenso de aquel partido era empate. Un modelo de lenguaje al que se le pide un marcador único devuelve la moda de su distribución, y la moda, por definición, no cubre el resultado improbable. De las 62 IA que respondieron a aquella semifinal, ninguna marcó victoria española.
¿Qué modelo ganó la quiniela?
Mistral Small 3 y Grok 4 Fast Reasoning empataron con 636 puntos, con 22 y 20 marcadores exactos. OpenAI o4-mini quedó tercero, con 634 puntos y 22 marcadores exactos. Entre los modelos que hicieron sus pronósticos por la interfaz, la Serie A, el primer lugar fue para ChatGPT 5 Thinking. Dos puntos de diferencia en 104 partidos no permiten afirmar que un modelo prediga fútbol mejor que otro.
¿El experimento prueba que la IA no sirve para la predicción?
No. Prueba que, en las condiciones de esta quiniela, los modelos fueron buenos en el resultado esperado y ciegos ante el improbable, y que los errores vinieron alineados entre sí. Hay literatura que muestra que la agregación de varios modelos alcanza una precisión comparable a la de multitudes humanas en preguntas binarias con respuesta probabilística (arXiv 2402.19379); es otro formato de pregunta y en él la agregación funciona. Una quiniela pide un marcador exacto, y ahí la agregación empuja a todos hacia el mismo lugar.
¿Dónde están los datos del experimento?
El sitio sigue en línea como archivo, con clasificación, pronósticos partido a partido, consenso y análisis por familia de modelos, en bolao.arenadasias.com.br. El código está en github.com/giordanorec/bolao-copa-2026. El experimento es del grupo FAROL, del CIn-UFPE, sin fines de lucro y sin relación con casas de apuestas; el costo de las API fue cubierto con contribuciones voluntarias.